
輝達Vera Rubin推論效能最高飆3.7倍 AI工廠每百萬瓦輸送量衝30倍
DSX MaxLPS動態調度電力、GPU數量最多增40%
【記者呂承哲/台北報導】隨著代理型AI(Agentic AI)帶動帶動推論工作負載快速增加,AI基礎設施競爭轉向能源效率。輝達(NVIDIA)公布Vera Rubin NVL72最新進展,首度參與MLPerf Inference v6.1預覽測試,輸送量最高達GB300 NVL72的3.7倍,搭配DSX MaxLPS更可在相同供電下增加最多40% GPU。
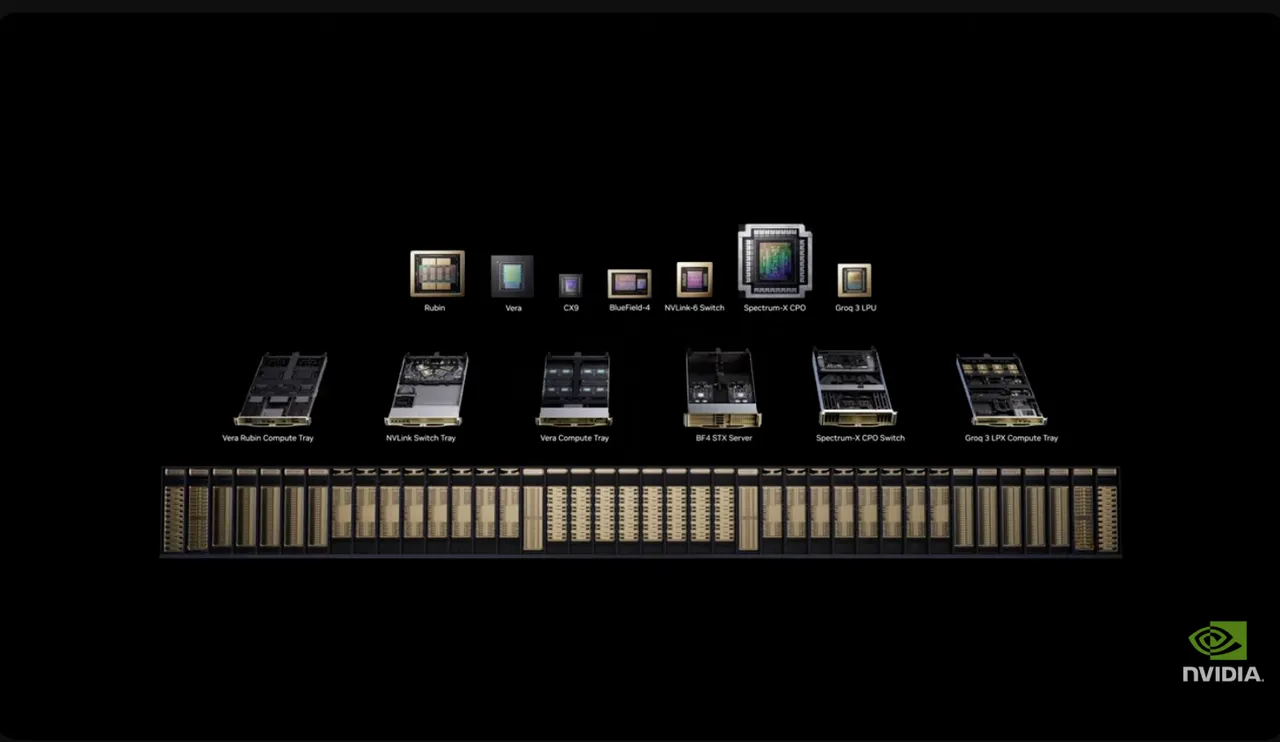
Vera Rubin首戰MLPerf 推論輸送量最高增3.7倍
輝達超大規模與高效能運算副總裁Ian Buck在AI Infra Summit指出,隨著代理型AI興起,基礎設施需要更高效能、效率及擴展能力。輝達全端AI工廠平台涵蓋Vera Rubin系統、Dynamo推論軟體、NeMo函式庫,以及NVLink、Spectrum-X乙太網路、ConnectX SuperNIC與BlueField DPU等網路及基礎設施技術。
在MLPerf Inference v6.1中,輝達針對DeepSeek-R1與Qwen3-VL兩項基準測試,提交Vera Rubin NVL72預覽結果。在離線、伺服器及互動情境下,Vera Rubin NVL72採用vLLM與NVIDIA Dynamo開源推論框架,Qwen3-VL輸送量最高達GB300 NVL72的3.7倍;DeepSeek-R1搭配TensorRT-LLM,輸送量則最高達2.5倍。
輝達指出,效能提升來自硬體與軟體全端協同設計,包括增強Tensor Core與Transformer Engine,加速推論預填充與解碼階段,NVFP4精度則可降低模型權重、注意力與KV快取的記憶體占用量,在幾乎不犧牲輸出品質下提高輸送量。
互連方面,Vera Rubin NVL72採用第六代NVLink與NVLink Switch,相較現成乙太網路可提供最高10倍封包速率,延遲降低3倍。GB300 NVL72則在DeepSeek-R1測試中,從單機架72顆GPU擴展至4座機架、共288顆GPU,仍達到99%擴展效率,輸送量幾乎隨硬體數量呈線性成長。
AI工廠比拚「每瓦詞元」 相同電力最多塞進40%更多GPU
除了單機效能,電力正成為AI工廠擴張的重要限制。輝達指出,AI基礎設施衡量指標正從峰值效能轉向「每百萬瓦代理型AI詞元數」,必須從晶片一路到電網進行協同設計。NVIDIA DSX MaxLPS可進行全工廠電力最佳化,將每百萬瓦產出的詞元數提升最多1.4倍。
以Vera Rubin NVL72為基礎的AI工廠,可透過DSX MaxLPS依需求在不同機架間動態分配電力,在相同站點供電範圍內,GPU數量最多增加40%,詞元輸送量最高提升35%,且無須增設電力線路;機架內則利用智慧型電力平滑化軟體及能源緩衝能力吸收短暫功率尖峰,把原本閒置的預留電力轉化為運算能力。
針對更複雜的代理型AI工作負載,Vera Rubin搭配Groq 3 LPX,在長情境、參數量超過2兆的模型中,每百萬瓦詞元輸送量最高可達GB200 NVL72的35倍;在情境長度10萬的Qwen 3.8 27B工作負載上,Groq 3 LPX則達到每位使用者每秒輸出2529個詞元。
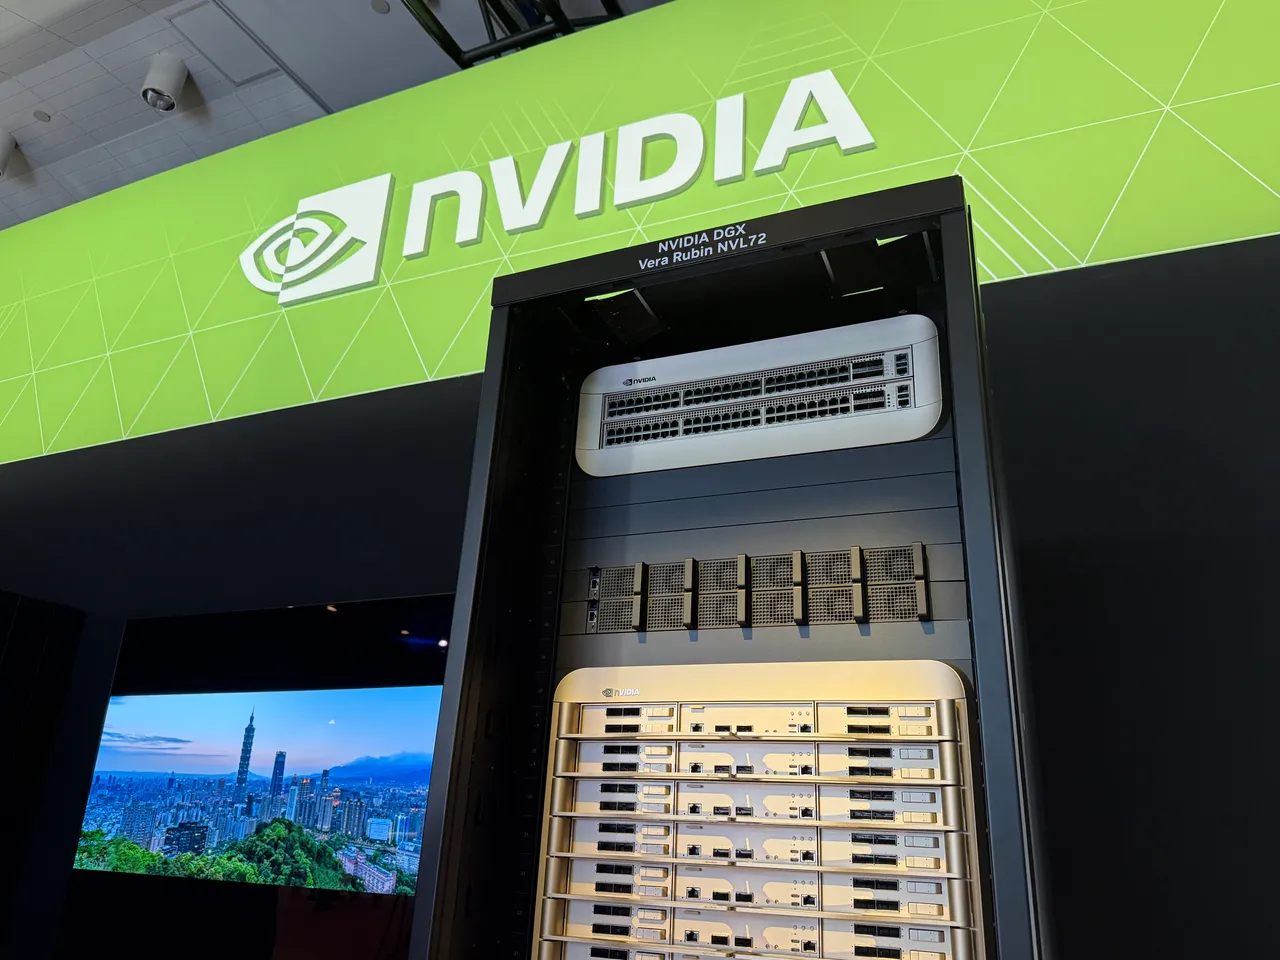
代理型AI工作量最多增30倍 每百萬詞元成本降45倍
另一項SemiAnalysis AgentX測試則聚焦真實世界代理型程式設計工作階段,納入情境增長、工具呼叫延遲及子代理啟動等因素。在DeepSeek V4 Pro模型上,Vera Rubin NVL72每百萬瓦輸送量最高達GB300 NVL72的30倍,意味相同能源使用量下,可完成最多30倍代理型工作,每百萬詞元成本則最多降低45倍。
軟體最佳化也是效能提升關鍵。MLPerf Inference v6.1結果顯示,GB300 NVL72在Qwen3-VL的效能最高達v6.0的1.6倍,改善來自較低精度KV快取、更多核心融合及vLLM與NVIDIA Dynamo分離式服務。此次測試共有19家輝達合作夥伴參與,其中8家採用多節點Blackwell NVL72系統。
隨AI工廠規模朝數十萬顆GPU發展,可靠性也成為關鍵。輝達表示,NVLink 6採多層韌性架構,在物理層透過前向錯誤更正、物理層重試等機制降低錯誤影響;網路層則藉由流量控制、動態路由及鏈路重新平衡,將故障限制在局部範圍,避免連鎖停滯影響整座AI工廠輸送量。
 點擊閱讀下一則新聞








